En junio de 2017, un equipo de ocho investigadores de Google Brain y Google Research publicó un artículo con el título: “Attention Is All You Need”. En aquel momento, el procesamiento del lenguaje natural (NLP) y el modelado de secuencias estaban dominados de forma indiscutible por las Redes Neuronales Recurrentes (RNN), sus variantes con compuertas (LSTM y GRU) y las arquitecturas convolucionales aplicadas a secuencias.
La tesis del paper proponía eliminar por completo la recurrencia y las convoluciones, basando la transducción de secuencias de principio a fin exclusivamente en un mecanismo de atención: el Transformer.
Aquella decisión de diseño no solo batió los récords del estado del arte en traducción automática (WMT 2014) con una fracción del coste de entrenamiento, sino que desencadenó el mayor cambio de paradigma en la historia de la inteligencia artificial. A continuación, desglosaremos con precisión matemática cómo funciona esta arquitectura, por qué resolvió el cuello de botella de la computación paralela y cómo ha llevado a la industria a una nueva frontera: de la carrera por los centros de datos a la resolución de problemas matemáticos del Milenio.
1. El Cuello de Botella Secuencial de las RNN
Para apreciar el impacto del Transformer, es imprescindible entender la limitación física que poseen las arquitecturas precedentes.
En una red neuronal recurrente clásica, el procesamiento de una secuencia de vectores de entrada genera una secuencia de estados ocultos mediante la ecuación de transición:
Donde es una función no lineal (como o las funciones de activación de compuertas en LSTMs).
Flujo Secuencial en RNN:
x_1 ──► [ Cell ] ──► h_1
           │
           ▼
x_2 ──► [ Cell ] ──► h_2   (Inhibe la paralelización en GPU: O(n) pasos)
           │
           ▼
x_3 ──► [ Cell ] ──► h_3
Esta formulación acarrea tres problemas computacionales y teóricos:
- Incompatibilidad con el hardware paralelo: Dado que el cálculo de depende estrictamente del resultado previo , el proceso es secuencial. En términos de complejidad, requiere operaciones secuenciales para una secuencia de longitud . Esto impide aprovechar la masiva capacidad de cómputo en paralelo de las GPUs y TPUs modernas durante el forward pass.
- Desvanecimiento y explosión del gradiente: Al calcular el Backpropagation Through Time, el gradiente fluye a través de cadenas sucesivas de multiplicaciones de matrices de pesos . Si los autovalores de son menores a 1, la señal decae exponencialmente, impidiendo capturar dependencias temporales distantes.
- El cuello de botella del vector de contexto: En los modelos tradicionales Encoder-Decoder basados en secuencias, el codificador comprimía toda la información semántica de una frase de 50 o 100 palabras en un único vector estático . A medida que la longitud de la secuencia crecía, la pérdida de información era catastrófica.
Aunque mecanismos tempranos como la atención aditiva de Bahdanau (2014) o la atención multiplicativa de Luong (2015) aliviaron la compresión del contexto, seguían anclados a celdas recurrentes subyacentes. El Transformer derribó esta barrera eliminando el bucle temporal por completo.
2. Técnica del Transformer
La arquitectura original descrita por Vaswani et al. está diseñada como un modelo Encoder-Decoder modular. Cada bloque se compone de capas idénticas apiladas.
A. Embeddings y Positional Encoding
Al prescindir de la recurrencia y de las convoluciones, el modelo carece de una noción innata de orden o posición de los tokens. Si alimentásemos una frase con las palabras desordenadas a un mecanismo de atención puro, el cálculo matricial produciría exactamente el mismo resultado (es una operación invariante a permutaciones):
Para subsanarlo, los autores introdujeron el Positional Encoding. Antes de entrar a la primera capa, al vector de embedding semántico de cada token (, donde ) se le suma un vector posicional determinista de su misma dimensión:
Utilizaron funciones trigonométricas de diferentes frecuencias:
Donde es la posición del token en la secuencia () e es el índice de la dimensión ().
¿Por qué funciones sinusoidales?
Por una excelente propiedad matemática: para cualquier desplazamiento fijo , el vector puede representarse como una proyección lineal de . Usando las identidades trigonométricas de adición:
Esto permite que las capas lineales de atención aprendan con gran facilidad a atender a posiciones relativas, además de permitir la extrapolación teórica a longitudes de secuencia más largas que las vistas durante el entrenamiento.
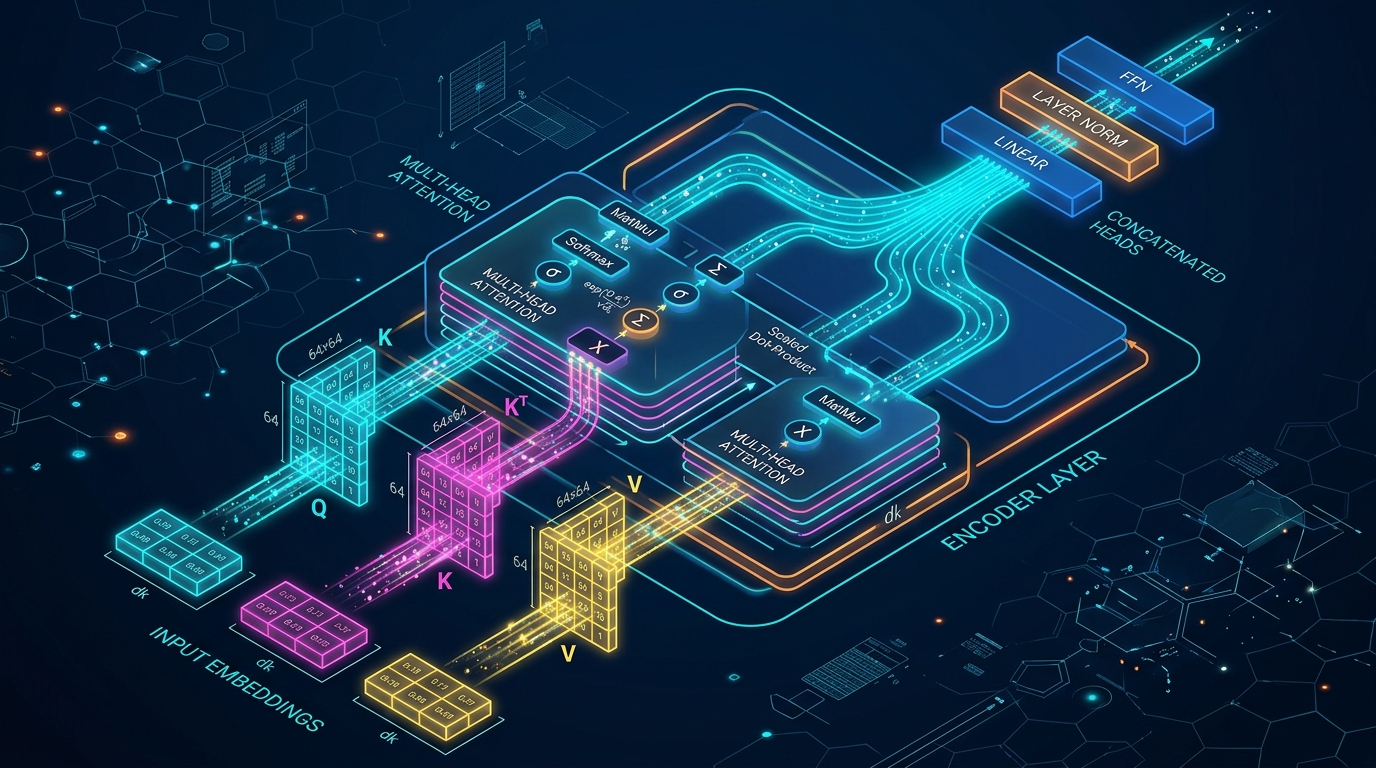
B. Scaled Dot-Product Attention
El núcleo operativo del Transformer es el mecanismo de Atención Producto Punto Escalada.
Conceptualmente, el mecanismo modela una consulta en un sistema de base de datos relacional:
- Query (): El vector que busca información relevante (representa al token actual preguntando: “¿A qué otros elementos debo atender?”).
- Key (): El vector que indexa y describe el contenido de cada token (responde: “¿Qué atributos poseo?”).
- Value (): La información de contenido contextual real que será transmitida y combinada.
Dadas las matrices empaquetadas , y , la fórmula fundamental se define como:
Flujo de Scaled Dot-Product Attention:
  Q ──┐
      ├─► [ MatMul (Q · K^T) ] ──► [ Scale (/ √d_k) ] ──► [ Mask (Opt.) ] ──► [ Softmax ] ──┐
  K ──┘                                                                                      ├─► [ MatMul ] ──► Salida
  V ─────────────────────────────────────────────────────────────────────────────────────────┘
Vamos a analizar cada término de esta ecuación:
1. Producto Matricial
Multiplica cada fila de por cada columna de . Produce una matriz de afinidad cuadrada de dimensión donde la celda contiene el producto escalar . Este producto escalar mide el grado de correlación o alineación vectorial entre el token y el token . Al resolverse mediante una multiplicación de matrices convencional (GEMM), se ejecuta a máxima velocidad en hardware gráfico especializado.
2. Factor de Escalado
Este factor es un detalle matemático importante del paper. Si asumimos que las componentes de y son variables aleatorias independientes e idénticamente distribuidas con media 0 y varianza 1:
A medida que la dimensión de los vectores crece (por ejemplo, o mayor), la magnitud del producto escalar crece hacia valores numéricos muy grandes. Al aplicar la función , valores muy elevados empujan la función a zonas de saturación donde las derivadas son casi nulas.
Esto causaría el desvanecimiento del gradiente durante el entrenamiento. Dividir por re-escala la varianza a la unidad (), preservando gradientes saludables y estables.
3. Normalización Softmax
Aplica la exponencial elemento a elemento sobre cada fila y normaliza por la suma de la fila. Transforma las afinidades continuas en una distribución de probabilidad discreta tal que .
4. Combinación Convexa de Valores ()
La matriz de pesos de atención se multiplica finalmente por . El vector resultante para el token es una combinación lineal de todos los valores de la secuencia, ponderados por su relevancia:
C. Multi-Head Attention
En lugar de calcular una única función de atención con vectores de tamaño completo , el Transformer divide la capacidad representacional proyectando linealmente y en cabezales independientes con dimensiones reducidas .
Matemáticamente:
Donde las matrices de proyección entrenables tienen las siguientes dimensiones:
En la configuración base del paper:
- cabezales paralelos
¿Por qué es superior el Multi-Head Attention?
Un solo cabezal tiende a promediar la atención entre distintas palabras, diluyendo las señales sutiles. Con múltiples cabezales, cada subespacio puede especializarse en un fenómeno lingüístico o relacional distinto:
- Un cabezal rastrea dependencias sintácticas (sujeto-verbo).
- Otro cabezal resuelve co-referencias pronominales distantes (vincular el pronombre “ella” con su antecedente nominal).
- Otro cabezal actúa como un detector de contexto local inmediato (similar a una convolución 1D).
Al mantener la dimensión de cada cabezal en , el coste computacional total de MHA es idéntico al de una atención de cabezal único de dimensión completa.
D. Simulador Interactivo: Mecanismo de Atención
Prueba a continuación cómo interactúan las consultas, claves y cabezales en distintos contextos lingüísticos y sintácticos:
Laboratorio de Scaled Dot-Product Attention
Haz clic en cualquier palabra (Token Query $q$) para inspeccionar cómo calcula su afinidad con las demás palabras (Keys $k$), la normalización softmax y la combinación de valores contextualizados.
Distribución de Atención: Softmax((Q · Kᵀ) / √dₖ)
Σ α = 1.0Traza de Operaciones Tensoriales
[-0.42, 1.18, 0.85, ...]
Token "animal" (Producto q · kᵀ = 18.4)
Escalado: 18.4 / √64 = 2.30
[0.72, -0.14, 1.45, ...]
La representación de "cansado" ahora absorbe la información semántica de "animal".
E. Redes Feed-Forward Posicionales
Tras el bloque de atención, cada capa contiene una red neuronal densa aplicada de manera idéntica e independiente a cada posición individual:
Consta de dos transformaciones lineales con una activación no lineal (ReLU en el paper original; en arquitecturas modernas como LLaMA se utiliza SwiGLU o GeLU):
- Expansión de dimensión: .
- Proyección de retorno: .
La capa FFN almacena la “memoria semántica asociativa” del modelo, procesando e integrando la información relacional extraída previamente por el bloque de atención.
F. Conexiones Residuales y Normalización
Alrededor de cada subcapa (tanto en MHA como en FFN), el Transformer incorpora una conexión residual seguida de una normalización de capa (Layer Normalization):
La conexión residual (), popularizada por ResNet, permite que los gradientes fluyan directamente hacia atrás sin atenuarse, posibilitando el entrenamiento estable de decenas o cientos de capas.
Detalle Importante (Post-LN vs Pre-LN):
El paper original de 2017 utilizó Post-LN (la normalización se aplica después de la suma residual). Esto provoca que en capas profundas las activaciones crezcan, obligando a usar un protocolo estricto de learning rate warmup para evitar que el entrenamiento diverja. Casi todas las arquitecturas modernas (como GPT-3, LLaMA o Mistral) migraron a Pre-LN: , lo que estabiliza el flujo de gradientes desde el inicio sin requerir hiperparámetros tan críticos.
G. Decodificador y Causal Masking
El Decodificador presenta dos diferencias cruciales frente al Codificador:
- Masked Multi-Head Attention (Máscara Causal): Durante el entrenamiento de tareas autorregresivas (generación de texto paso a paso), el modelo procesa toda la frase objetivo en paralelo. Para evitar que el token en la posición “haga trampas” mirando tokens futuros , se suma una máscara triangular superior con valores a la matriz antes de la función softmax:
Al calcular , los pesos de atención hacia el futuro quedan estrictamente anulados.
- Cross-Attention: En este bloque, los vectores de consulta () provienen de la capa previa del decodificador, mientras que las claves () y valores () provienen de la salida final del codificador. Esto permite que cada palabra que se está generando atienda dinámicamente a toda la frase original de entrada.
3. Complejidad Asintótica: Self-Attention vs RNN vs CNN
Uno de los aportes teóricos más reveladores de fue la comparación directa de la complejidad computacional entre familias de capas para procesar secuencias de longitud con dimensión de representación :
| Tipo de Capa | Complejidad por Capa | Operaciones Secuenciales | Longitud Máxima de Ruta |
|---|---|---|---|
| Self-Attention | |||
| Recurrent (RNN/LSTM) | |||
| Convolutional (1D) | |||
| Self-Attention (Restricted) |
De esta tabla se desprenden conclusiones determinantes:
- Operaciones Secuenciales : Mientras que las RNNs requieren pasos secuenciales obligatorios, la autoatención conecta todas las posiciones en una única operación paralela matricial. Esto desbloqueó la saturación de los clústeres de aceleradores de cómputo.
- Longitud Máxima de Ruta : Para que la información viaje del primer al último token en una RNN, debe atravesar estados intermedios. En el Transformer, cualquier par de tokens interactúa en un solo salto (), erradicando el olvido de dependencias a larga distancia.
- El Trade-off Cuadrático : Para contextos habituales donde (por ejemplo, secuencias de 512 tokens con representaciones de dimensión 1024 o 4096), la autoatención es sustancialmente más económica que una capa recurrente o convolucional. Sin embargo, para contextos masivos (), el coste en memoria crecía cuadráticamente, lo que años después impulsó invenciones como FlashAttention, atención por ventanas deslizantes y mecanismos lineales.
4. El Cambio de Paradigma en el Deep Learning
El Transformer trascendió instantáneamente la traducción automática para convertirse en el sustrato unificado de la inteligencia artificial moderna.
                  ┌──► Solo Encoder (BERT, RoBERTa) ──► Embeddings, Búsqueda, Clasificación
                  │
TRANSFORMER ──────┼──► Solo Decoder (GPT, LLaMA, Claude) ──► LLMs Generativos, Razonamiento
                  │
                  ├──► Visión por Computador (ViT) ──► Sustitución de CNNs en clasificación y segmentación
                  │
                  ├──► Biología Estructural (AlphaFold 2/3) ──► Plegamiento de proteínas en 3D
                  │
                  └──► Modelos Multimodales (CLIP, Whisper, Sora) ──► Audio, Imagen y Video generativo
Leyes de Escala
Antes del Transformer, añadir más capas a una red neuronal a menudo provocaba rendimientos decrecientes o inestabilidades de gradiente. La combinación de autoatención, normalización y residuos del Transformer demostró una propiedad inédita formalizada en 2020 y afinada en 2022: las Leyes de Escala.
El rendimiento (medido en pérdida de entropía cruzada) escala como una ley de potencias predecible () a medida que se incrementan tres factores:
- El cómputo total de entrenamiento ( en FLOPs).
- El volumen de datos del dataset ( en tokens).
- El número de parámetros del modelo ().
Esta predictibilidad matemática provocó la revolución de los Modelos de Lenguaje Masivos (LLMs), permitiendo a la industria invertir miles de millones de dólares sabiendo con exactitud matemática qué nivel de capacidad obtendrían al desplegar clústeres de supercomputación más grandes.
5. La Carrera de los Problemas Matemáticos
El éxito del Transformer desató una primera era marcada por una carrera industrial voraz: la construcción de centros de datos a escala de gigavatios, la acumulación de cientos de miles de GPUs (como las arquitecturas Hopper y Blackwell de NVIDIA) y el consumo masivo de energía para maximizar los parámetros de pre-entrenamiento.
Sin embargo, a medida que la industria alcanzó el denominado “data wall” (el agotamiento del texto público generado por humanos en internet), el paradigma volvió a mutar: el escalado bruto de parámetros ya no es suficiente.
El nuevo frente de batalla no radica únicamente en construir centros de datos más grandes, sino en el cómputo en tiempo de inferencia (test-time compute), el razonamiento guiado por búsqueda y la resolución de problemas científicos y matemáticos rigurosos. La IA ha pasado de predecir el siguiente token verosímil a verificar demostraciones formales libres de alucinaciones.
El Hito de OpenAI y las Ecuaciones de Navier-Stokes
La confirmación más contundente de este cambio de era ocurrió en septiembre de 2026, cuando OpenAI presentó su investigación técnica sobre uno de los desafíos más profundos de la física matemática: el problema de existencia y suavidad de las ecuaciones de Navier-Stokes.
Las ecuaciones de Navier-Stokes, formuladas en el siglo XIX, describen las leyes fundamentales que gobiernan el movimiento de los fluidos (desde el aire que envuelve el ala de un avión hasta la turbulencia atmosférica). Determinar si las soluciones a las ecuaciones en tres dimensiones siempre se mantienen suaves y físicamente acotadas para todo tiempo, o si por el contrario pueden colapsar y desarrollar una singularidad matemática (blowup en tiempo finito donde la energía o la velocidad tiendan a infinito), es uno de los Siete Problemas del Milenio catalogados por el Instituto Clay de Matemáticas, con una recompensa de un millón de dólares.
Matemáticamente, para un fluido incompresible tridimensional con densidad constante , el sistema se formula mediante dos ecuaciones fundamentales:
Donde cada término describe un componente físico del movimiento del fluido:
- : Aceleración temporal (cambio de velocidad en el tiempo).
- : Término convectivo no lineal (el fluido transportándose a sí mismo; origen del comportamiento caótico y la turbulencia).
- : Gradiente de presión interna.
- : Difusión viscosa (fricción interna que disipa la energía cinética).
- : Fuerza externa aplicada.
- : Condición de incompresibilidad (conservación de masa).
El Problema: Dadas unas condiciones iniciales suaves y de energía cinética finita , ¿existen siempre soluciones regulares y diferenciables para todo tiempo , o puede la interacción no lineal concentrar la vorticidad hasta provocar una singularidad en tiempo finito (finite-time blowup, donde la velocidad o el gradiente tiendan a infinito)?
En su trabajo titulado, OpenAI anunció que un sistema avanzado de agentes de inteligencia artificial coordinados resolvió las alternativas (C) y (D) planteadas por el matemático Charles Fefferman en la formulación oficial del Milenio:
- El Resultado: Demostraron matemáticamente la existencia de un contraejemplo con ruptura en tiempo finito (finite-time blowup) para fluidos incompresibles tridimensionales a partir de condiciones iniciales suaves, bajo la influencia de una fuerza externa suave.
- El Método Computacional: Lejos de ser una red neuronal actuando como un aproximador numérico difuso, el sistema utilizó modelos fundacionales integrados con optimizadores de segundo orden para refinar geometrías singulares complejas y formalizó la demostración completa en Lean, un lenguaje de programación y asistente de demostración formal interactivo. Al codificar la prueba en Lean, cada paso lógico deductivo queda verificado algorítmicamente por un verificador formal determinista, eliminando la posibilidad de error humano o alucinación estadística.
Conclusión Final: P vs. NP
Resulta extraordinario contemplar la trayectoria trazada en menos de una década. En 2017, un equipo de ingenieros buscaba una forma más eficiente de traducir frases del inglés al alemán en los servidores de Google Translate sin que el entrenamiento tardase semanas en converger.
Al sustituir las restricciones secuenciales por matrices de autoatención pura, crearon sin sospecharlo una máquina universal de procesamiento de información relacional. Esa misma arquitectura, multiplicada por millones de núcleos de cómputo y refinada con sistemas de razonamiento formal y asistentes de demostración, ha transformado el Deep Learning: de una herramienta probabilística para clasificar imágenes o predecir texto a un instrumento científico capaz de resolver o avanzar sobre los misterios más complejos de la física teórica y las matemáticas.
Sin embargo, este avance conduce inevitablemente a una pregunta aún más trascendental en la intersección entre la computación teórica y la inteligencia artificial: ¿hasta dónde puede llegar la capacidad algorítmica para resolver problemas de esta complejidad?
En el panorama de esta nueva frontera científica emerge uno de los problemas no resueltos del Milenio: el problema de contra ().
Formulado formalmente por Stephen Cook en 1971, cuestiona si todo problema cuya solución puede ser verificada eficientemente (en tiempo polinomial, clase ) también puede ser resuelto con la misma rapidez algorítmica (clase ).
Si algún día la investigación algorítmica —asistida o impulsada por sistemas avanzados de inteligencia artificial— lograse demostrar de forma constructiva que , el impacto sobre la civilización humana, la computación y la ciencia sería inmenso:
- El Colapso de la Criptografía Moderna: Prácticamente toda la seguridad digital global (cifrado RSA, curvas elípticas, intercambios Diffie-Hellman y la infraestructura de internet) se sustenta en la asimetría computacional: es trivial multiplicar dos números primos gigantes, pero intratable factorizar su producto. Si , cualquier clave criptográfica asimétrica podría vulnerarse en tiempo polinomial, forzando una reconstrucción absoluta de la ciberseguridad.
- La Automatización Total del Descubrimiento Matemático: Validar si un paso inductivo o una demostración formal es correcta es un problema en . Si , encontrar la demostración sería asintóticamente tan sencillo como comprobarla. Cualquier conjetura formulable en un verificador formal determinista (como Lean) podría ser demostrada automáticamente por un algoritmo en tiempo polinomial. Como señaló célebremente el teórico computacional Scott Aaronson: si , cualquiera capaz de apreciar una sinfonía podría componer como Mozart, y cualquiera capaz de comprender una prueba matemática podría deducirla como Gauss.
- Optimización Perfecta: Problemas NP-completos e intratables que hoy solo abordamos con heurísticas aproximadas —el plegamiento macromolecular óptimo, el diseño de fármacos dirigidos a dianas moleculares complejas, la síntesis automatizada de circuitos lógicos o la logística de cadenas de suministro globales— se resolverían mediante algoritmos exactos de máxima eficiencia.
Aunque el consenso mayoritario de la comunidad matemática y computacional sostiene que (que verificar siempre será intrínsecamente más fácil que descubrir), la lección indiscutible que nos deja el linaje del Transformer es que las fronteras de lo computable se están expandiendo a un ritmo increible. Lo que comenzó como un refinamiento algebraico para no bloquear las GPUs al procesar lenguaje natural se ha transformado en el motor computacional que hoy explora los límites de la ciencia.
Referencias
- 📄 Vaswani et al. (2017) - Attention Is All You Need: El paper fundacional del Transformer.
- 📄 Ba, Kiros, & Hinton (2016) - Layer Normalization: Base teórica de la normalización por capas utilizada en el Transformer.
- 📄 Kaplan et al. (2020) - Scaling Laws for Neural Language Models: Formalización de las leyes de potencia que rigen el escalado computacional.
- 📄 Dao et al. (2022) - FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness: Optimización del acceso a memoria GPU que superó la barrera cuadrática en producción.
- 📄 OpenAI (2026) - Finite Time Blowup for Navier–Stokes: Demostración y formalización en Lean del problema de Navier-Stokes con agentes de IA.
- 📄 Clay Mathematics Institute - The Millennium Prize Problems: Navier-Stokes Existence and Smoothness: Descripción matemática formal por Charles L. Fefferman.
- 📄 Cook (1971) - The Complexity of Theorem-Proving Procedures: Artículo seminal que introdujo el concepto de NP-completitud y el problema P vs. NP.
- 📄 Clay Mathematics Institute - The Millennium Prize Problems: P vs NP Problem: Descripción matemática formal por Stephen Cook.
